ChindaMT:遵循您规则的泰英翻译,研究成果发表于 AACL-IJCNLP 2026

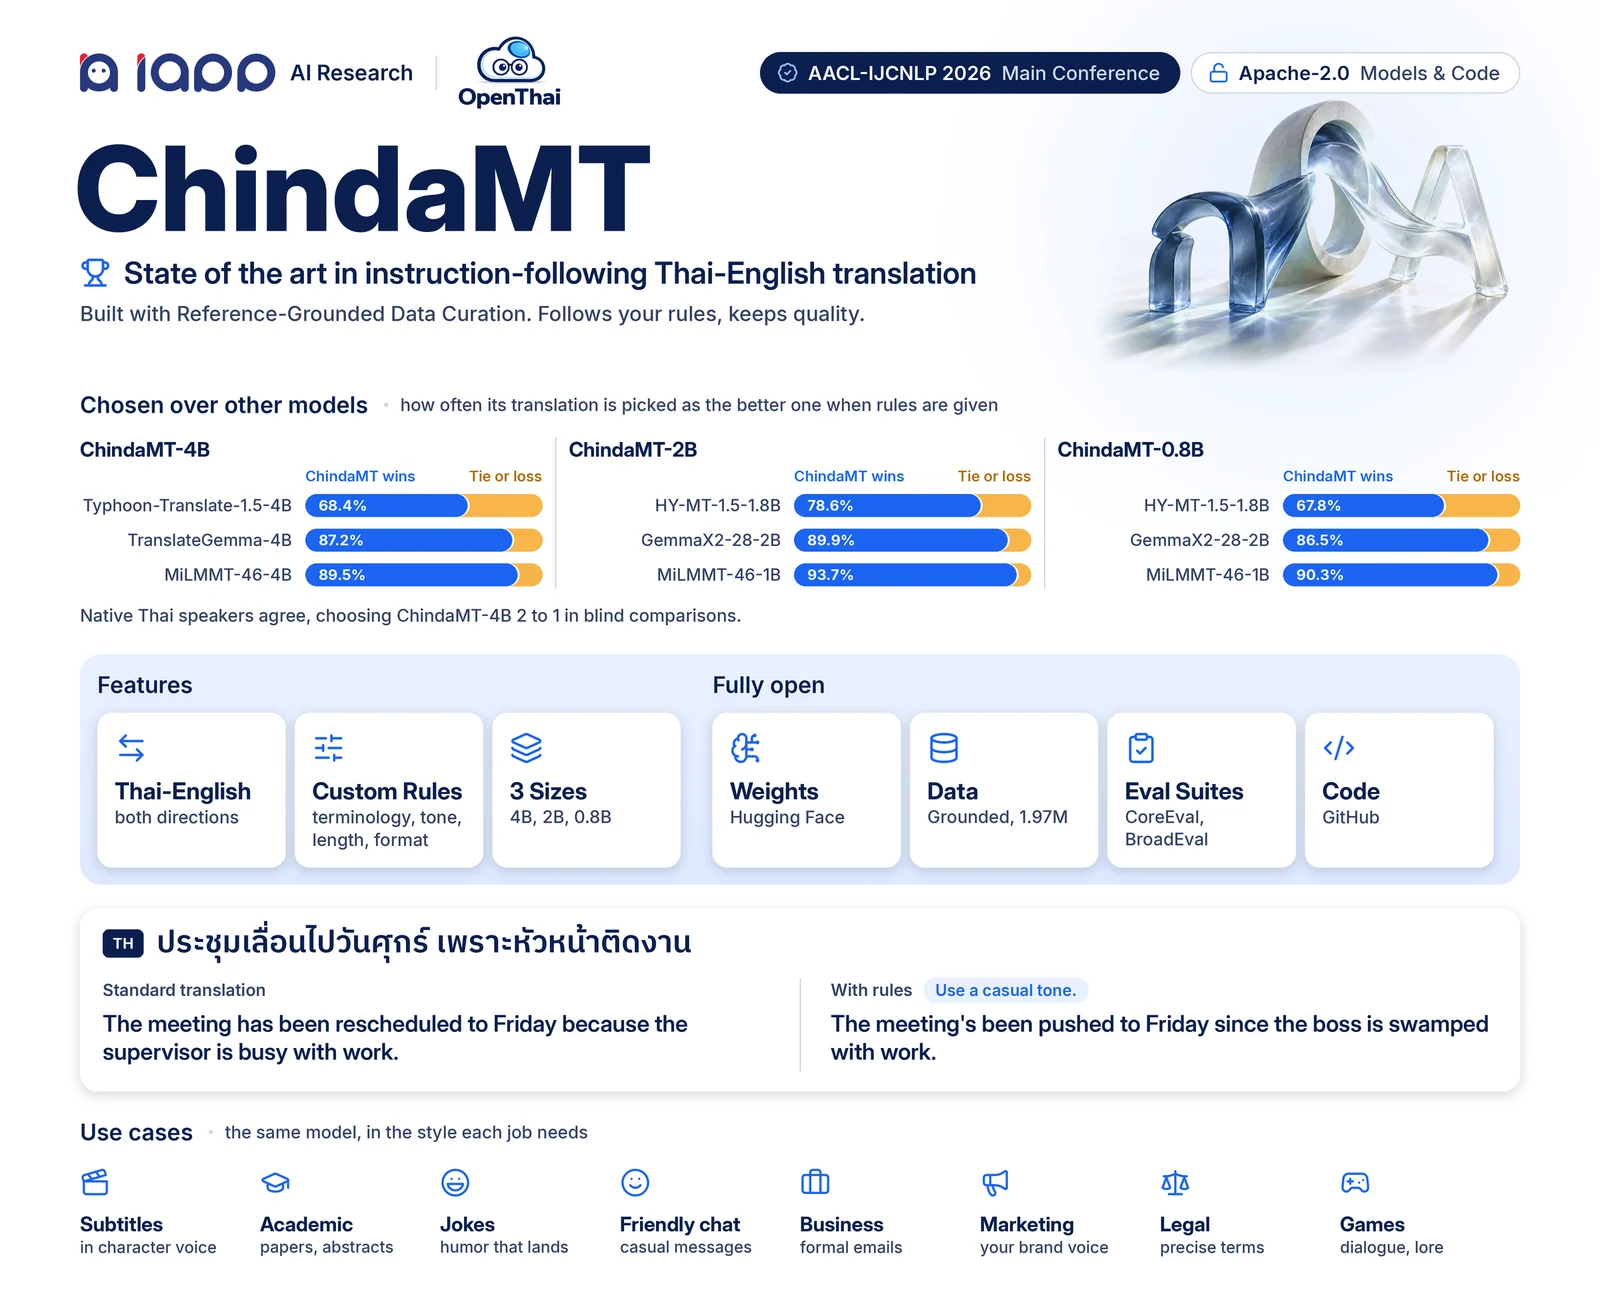
今天,我们发布 ChindaMT。这是一个泰英翻译模型系列,能够遵循您给出的规则:使用哪个术语、采用何种语气,以及长度和格式。相关研究发表于 AACL-IJCNLP 2026(主会)。模型、训练数据、评测集和代码均以 Apache 2.0 许可开放,ChindaMT-4B 现已作为托管 API 提供。
试用:ChindaMT 翻译器 · API:文档与在线演示 · 论文:arxiv.org/abs/2609.34770 · 模型权重:huggingface.co/iapp/ChindaMT-4B
译文正确,却未必适合实际用途
以这句话为例:“The meeting has been moved to Friday because the boss is busy.”
标准译法是 การประชุมถูกเลื่อนไปเป็นวันศุกร์เนื่องจากเจ้านายยุ่ง。每个词都正确,但没有人会在群聊里这样打字。要求 ChindaMT “use a casual, friendly tone”(使用轻松友好的语气),它会写出 ประชุมย้ายไปวันศุกร์แล้วนะ เพราะเจ้านายยุ่งมาก。
翻译很少只有一个标准答案。字幕需要角色的口吻,论文需要正式语体,品牌需要自己的风格,合同需要始终使用同一个术语。难点在于:越是要求模型严格遵循此类规则,其翻译质量往往下降越多。专门的翻译模型译得好,却会忽略指令;通用的指令遵循模型听从指令,翻译质量却不够好。此前还没有任何开源泰英模型弥合这一差距。
答案在数据中
我们采用一种称为 Reference-Grounded Data Curation(RGDC,基于参考译文的数据整理) 的方法构建训练数据。RGDC 不是让语言模型凭空编造规则、再寄希望于这些规则能被满足,而是从一份已经满足规则的优质参考译文中提取每一条规则。如果参考译文将 บาท 译为“THB”、保持为一句话且语气正式,这些就成为该样本的规则。由于已有真实译文满足它们,这些规则在构造上就必然可以实现。
该流程从十个公开语料库中的 1,785 万个英泰句对出发。第一阶段保留其中最难但仍可学习的 175 万个句对。第二阶段从每份参考译文中提取五类规则(内容、数字、风格、格式、语言),在这些规则下重新生成译文,并只保留通过全部规则的候选译文。最终得到 Grounded 数据集,共 197 万条记录,平均每条带有 3.7 条规则。
结果
我们微调了 4B、2B 和 0.8B 三种规模,并在两个翻译方向上、有规则和无规则的条件下,分别与同规模的开源翻译模型进行对比。下表为给出规则时评审模型更偏好 ChindaMT 译文的比例(50% 表示持平):
| ChindaMT | 对比对象 | 偏好率 |
|---|---|---|
| 4B | Typhoon-Translate-1.5-4B | 68.4% |
| 4B | TranslateGemma-4B | 87.2% |
| 4B | MiLMMT-46-4B | 89.5% |
| 2B | HY-MT-1.5-1.8B | 78.6% |
| 2B | GemmaX2-28-2B | 89.9% |
| 0.8B | HY-MT-1.5-1.8B | 67.8% |
| 0.8B | GemmaX2-28-2B | 86.5% |
遵循规则并没有以牺牲翻译质量为代价。在公开基准 FLORES-200 上,ChindaMT-4B 在三项质量指标上的平均分为 90.7,是所测 4B 至 9B 模型中最高的。三位以泰语为母语的评审在不知道译文出自哪个模型的情况下,对匿名译文对进行评分,在带规则翻译中有 69% 更偏好 ChindaMT-4B,总体为 67%,比例超过二比一。同一方法在固定设置下也提升了另一代模型,这表明性能提升来自数据,而非某个特定的基础模型。
使用方式
网页版。 ChindaMT 翻译器支持使用您自己的规则进行翻译,并将结果与不带规则的译文进行对比。
API。 ChindaMT-4B 已在 POST https://api.iapp.co.th/v3/store/text/mt/translate 上线,另有用于界面字符串和表格单元格的批量接口。每次请求最多 100,000 个字符,一句话约 0.4 秒返回,五页文本约 1.7 秒。价格为每 400 个源文本字符 1 IC;规则免费,失败的请求不计费。详细信息见 API 文档。
curl -X POST https://api.iapp.co.th/v3/store/text/mt/translate \
  -H "apikey: YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"text": "The meeting has been moved to Friday because the boss is busy.", "source_lang": "en", "target_lang": "th", "rules": ["Use a casual, friendly tone"]}'
在自有硬件上运行。 三种规模均以 Apache 2.0 许可开放。0.8B 模型足够小,可以在笔记本电脑上运行。
| 发布内容 | 链接 |
|---|---|
| 模型(Apache 2.0) | ChindaMT-4B, ChindaMT-2B, ChindaMT-0.8B |
| 训练数据,197 万条记录 | ChindaMT-Grounded |
| 评测集 | ChindaMT-CoreEval, ChindaMT-BroadEval |
| 代码 | github.com/iapp-technology/ChindaMT-RGDC |
| 论文 | arxiv.org/abs/2609.34770 |
需要内置自有术语,或出于数据安全需要本地部署的机构,可联系 sale@iapp.co.th。
限制
ChindaMT 仅支持泰语和英语。它遵循的是优质参考译文能够体现的规则类型:术语、语气、长度和输出格式。大型强制术语表和严格的占位符标记不在其训练范围内。与任何机器翻译一样,它可能生成流畅但错误的文本,因此用于法律、医疗等高风险场景的译文应经人工审核;API 会在 warnings 字段中标出可能存在的问题。
致谢
ChindaMT 由 iApp AI Research 团队与 Thanaruk Theeramunkong 教授共同完成。感谢 SiamAI 提供计算资源,感谢 OpenThai Lab 的支持,也感谢三位自愿担任评审的泰语母语者。